FR
De nombreux systèmes de mémoire pour agents sont battus par la recherche directe dans l’historique
Memory Tax: Dissecting the Net Value of Agent Memory · arXiv:2610.34073
En termes simples
L’article cherche à savoir si un agent répond mieux aux questions en transformant ses anciennes conversations en résumés ou en faits stockés, plutôt qu’en recherchant directement dans les conversations d’origine. Les auteurs appellent memory benefit et memory tax les deux écarts possibles : les questions auxquelles la mémoire répond correctement alors que la recherche directe échoue, et celles auxquelles la mémoire échoue alors que la recherche directe réussit.
Dans plusieurs tests, de nombreuses mémoires construites répondent correctement à moins de questions que la recherche directe, même si certaines réussissent mieux sur des questions précises. Des vérifications supplémentaires suggèrent que la mémoire peut perdre de l’information lors de sa construction ou rendre plus difficile la recherche d’informations pourtant conservées.
La recherche
Quand un agent répond à des questions sur des conversations passées, transformer celles-ci en mémoire organisée améliore-t-il les réponses par rapport à une simple recherche dans l’historique d’origine ?
Sans comparaison directe, il est difficile de savoir si le traitement de la mémoire apporte une valeur supplémentaire ou si la recherche suffit à expliquer les réponses.
Les auteurs comparent les mémoires construites à la recherche directe dans l’historique brut, puis comptent les réussites et les échecs de la mémoire sous les noms de memory benefit et de memory tax.
Les auteurs ont comparé des mémoires construites à une recherche directe dans trois jeux de test sur la mémoire conversationnelle. Un modèle de langage chargé de l’évaluation a comparé les réponses à des références.
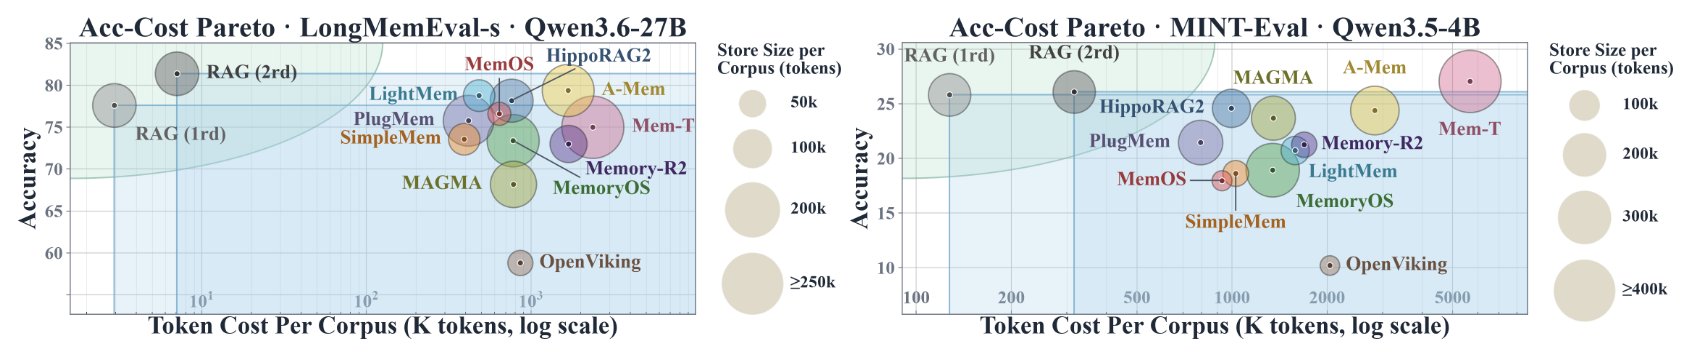
Dans de nombreuses conditions testées, plusieurs systèmes ont obtenu des scores inférieurs à ceux de la recherche directe, avec des variations selon le système et le contexte.
Les comparaisons question par question font apparaître à la fois des réussites et des échecs de la mémoire.
Ces résultats étayent une évaluation de la mémoire comme un équilibre : son organisation peut aider, mais le traitement ou la récupération peut aussi rendre des informations utiles plus difficiles à exploiter.
Ces comparaisons portent sur les systèmes et les modèles de base étudiés, ainsi que sur des tests majoritairement hors ligne et en anglais.
Certains résultats s’appuient sur des sous-ensembles stratifiés. L’étude ne permet pas de déterminer les performances de la mémoire dans des déploiements multilingues et prolongés, ni avec des formes de mémoire non testées ou des modèles plus puissants.
Ce que montrent les preuves
- La question posée sur la mémoire
Cet article est une étude empirique de la mémoire à long terme des agents. Il cherche à savoir si transformer les conversations passées en résumés, en faits ou en d’autres éléments stockés améliore les réponses par rapport à une recherche directe dans l’historique brut.
Cette comparaison est essentielle : les performances d’un système de mémoire, prises seules, ne montrent pas si son traitement supplémentaire apporte quelque chose au-delà de la recherche.
- Comparer à la recherche directe
Les auteurs comparent des systèmes représentatifs à mémoire construite à la génération augmentée par récupération directe, qui recherche des passages pertinents dans un historique peu transformé. Un modèle de langage chargé de l’évaluation compare les réponses à des références dans trois jeux de test sur la mémoire conversationnelle.
Dans de nombreuses conditions testées, plusieurs systèmes de mémoire obtiennent des scores inférieurs à ceux de la recherche directe, même si certains la dépassent pour des combinaisons précises de tests et de modèles.
- Compter les réussites et les échecs
Un score calculé sur l’ensemble des questions peut masquer des résultats opposés. Les auteurs comptent comme memory benefit les questions auxquelles un système de mémoire répond correctement alors que la recherche directe échoue, et comme memory tax celles auxquelles la recherche directe répond correctement alors que la mémoire échoue.
Leur comparaison question par question fait apparaître ces deux types de résultats : la mémoire n’est donc pas systématiquement meilleure ou moins bonne que la référence.
- Repérer l’origine des pertes
Pour localiser les pertes, les auteurs fournissent directement les éléments de preuve connus, puis relancent séparément la recherche afin de mesurer la rapidité avec laquelle elle retrouve les informations stockées. Ces vérifications indiquent que des informations peuvent être perdues pendant la construction de la mémoire ou devenir plus difficiles à récupérer alors qu’elles y sont encore présentes.
Les tests portant sur d’autres tâches que les conversations varient eux aussi selon le contexte ; ils étayent donc l’existence d’un compromis limité aux tâches étudiées, plutôt qu’un avantage général de la mémoire.
Détails
- Auteurs de l’article original
- Xuan He, Sining Zhoubian, Ruozhen Yang, Yuhao Wen, Zhineng Wang
- Soumis à arXiv
- Licence
- CC BY 4.0