ES
Los anchors compartidos permiten transferir monitores entre modelos de lenguaje
Relative Representations Enable Portable White-Box Monitoring Across Language Models · arXiv:2610.28366
En palabras sencillas
Un probe es un monitor que lee las activaciones internas de un modelo de lenguaje para predecir algo sobre su comportamiento. Este artículo presenta los probes globales con anchors, que describen cada ejemplo según su distancia respecto de los mismos ejemplos compartidos en distintos modelos.
Así, los monitores usan coordenadas con el mismo significado, aunque los modelos tengan tamaños diferentes. Los autores observaron que un monitor fijo a menudo seguía prediciendo resultados en tareas de cultura general, seguridad y matemáticas al cambiar de modelo.
Los resultados variaron según la tarea y el modelo de destino, e incluyeron un fallo de transferencia matemática en un modelo externo.
La investigación
¿Puede seguir funcionando un monitor de comportamiento entrenado en un modelo de lenguaje al cambiar a otro, si las coordenadas de sus activaciones internas pueden ser distintas incluso con la misma anchura?
Los autores estudian si expresar los ejemplos en coordenadas compartidas conserva la señal necesaria para predecir el comportamiento del modelo sin ejemplos etiquetados del destino.
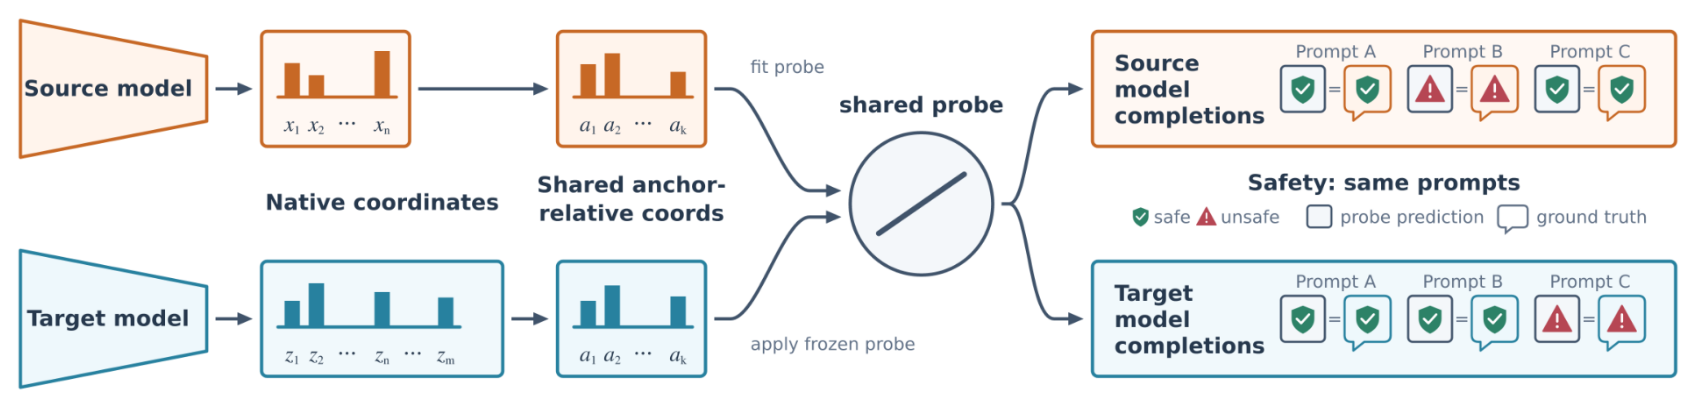
Los autores representan las activaciones de los modelos mediante distancias respecto de ejemplos compartidos y reutilizan un probe fijo para comprobar si el comportamiento sigue siendo predecible entre modelos.
Los autores representan cada ejemplo mediante sus distancias angulares respecto de los mismos ejemplos de referencia identificados en ambos modelos, entrenan un probe en uno, lo dejan fijo y lo evalúan en otro.
En tareas de cultura general, seguridad y matemáticas, la transferencia calibrada siguió siendo predictiva en promedio.
AUROC mide qué tan bien un probe ordena los casos positivos por encima de los negativos al variar los umbrales de decisión. Al promediar por separado cada configuración, la transferencia conservó al menos el 85% del AUROC del mismo modelo por encima del azar.
Como la regla de decisión del probe de origen siguió siendo predictiva en otro modelo, el resultado respalda una compatibilidad funcional en estas tareas evaluadas.
La transferencia varió según la tarea y el modelo de destino. En el modelo externo GPT-OSS-20B, un probe matemático transferido quedó cerca del azar, aunque un probe entrenado después en ese modelo pudo predecir la corrección. El estudio no establece por qué falló la transferencia.
Qué muestran las pruebas
- Por qué cuesta transferir un monitor
Un probe lee las activaciones internas de un modelo de lenguaje para predecir un comportamiento, como la respuesta que elegirá o si una solución es correcta. Sin embargo, por lo general no se puede aplicar directamente a otro modelo un probe entrenado con las activaciones propias del primero: las coordenadas de activación pueden diferir incluso si ambos modelos tienen la misma anchura.
El artículo pregunta si una representación compartida puede permitir que el mismo monitor de comportamiento funcione entre modelos entrenados por separado, sin etiquetas del modelo de destino.
- Cómo los anchors alinean las características
El artículo presenta los probes globales con anchors, un método que representa cada ejemplo mediante sus distancias angulares respecto de ejemplos de referencia compartidos. Los autores combinan las activaciones de todas las capas del transformer antes de calcular esas distancias, de modo que cada coordenada resultante corresponde al mismo ejemplo de referencia en cada modelo.
Así, un probe entrenado con la representación de un modelo puede dejarse fijo y aplicarse a otro, sin elegir capas correspondientes ni aprender un adaptador específico para el destino.
- Comprobar la señal antes de reutilizarla
Antes de probar la transferencia, los autores comprueban si el uso de anchors conserva la señal predictiva dentro de un modelo. Comparan probes estándar sobre activaciones propias con probes basados en anchors para las mismas tareas y etiquetas.
En MATH-500, con el prefijo de solución preestablecido de 128 tokens y 2,000 ejemplos de entrenamiento, el probe con anchors alcanza 81.8 AUROC, frente a 77.9 del probe estándar. Las comparaciones evaluadas de cultura general y seguridad también muestran diferencias pequeñas.
- Qué se conserva al cambiar de modelo
Luego, los autores dejan fijos los probes entrenados en modelos de origen y los aplican a modelos de destino. Eligen el origen con resultados de validación de otros modelos del grupo de origen, en vez de usar etiquetas del destino.
Al promediar por separado cada configuración de tarea, la transferencia calibrada conserva al menos el 85% del AUROC del mismo modelo por encima del azar en predicción de respuestas de cultura general, corrección de esas respuestas, supervisión de seguridad y corrección matemática en línea.
Estos promedios muestran que la capacidad predictiva continuó en las configuraciones evaluadas, pero no describen el resultado en cada modelo de destino.
- Las excepciones acotan el resultado
El patrón de transferencia tiene excepciones importantes. Para la corrección de respuestas binarias de TruthfulQA, la transferencia calibrada promedia 73.1 AUROC, frente a 89.1 de los probes evaluados en el mismo modelo, y los probes transferidos quedan cerca del azar en uno de los destinos.
En la tarea matemática con GPT-OSS-20B, un modelo externo, la transferencia queda cerca del azar, aunque un probe entrenado después en ese modelo puede predecir la corrección. Los autores interpretan las transferencias exitosas como evidencia de una organización compartida relevante para la tarea; los fallos muestran que la portabilidad depende de la tarea y del modelo de destino.
Detalles
- Autores del paper original
- Tim Bakker, Christos Louizos
- Enviado a arXiv
- Licencia
- CC BY 4.0