FR
Une étude à état fixe mesure ce qui aide les agents à réparer du code
Where Should a Stuck Agent Spend Its Next Tokens? Causal Attribution of Inference-Time Resources · arXiv:2610.28834
En termes simples
Quand un agent de programmation se trompe, il peut avoir besoin de plus de temps pour réfléchir, d’informations utiles sur le comportement attendu du programme, ou de retours provenant de tests. Il est difficile de savoir quelle ressource l’a aidé si le travail de l’agent change en même temps.
L’article propose une méthode pour comparer ces ressources à partir de copies d’une même tentative échouée. Pour les tâches concernant une fonction, les descriptions vérifiées du comportement attendu ont généralement davantage aidé que les retours des tests publics, parmi les six modèles de réparation évalués. L’étude mesure une seule révision à la fois.
La recherche
Quand un agent de programmation est bloqué, quelle ressource aide vraiment sa prochaine réparation : plus de calcul, des informations sur le comportement attendu du code, ou des retours de tests ?
Dans une séquence de réparation qui évolue, ces entrées sont difficiles à distinguer des changements de l’état de l’agent et de ses révisions.
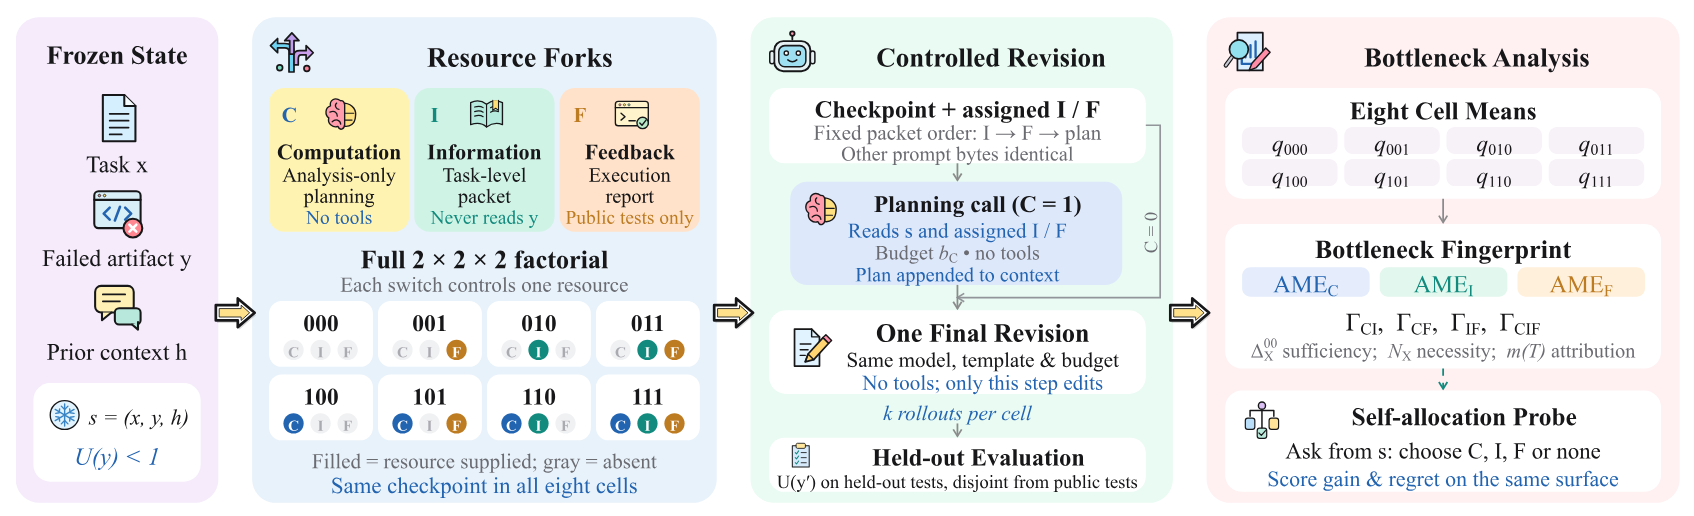
BRA crée des copies du même état d’échec avec différentes combinaisons de ressources, puis compare la contribution moyenne de chacune à une dernière révision.
BRA compare les ressources en donnant à des copies du même état d’échec différentes combinaisons de calcul, d’information et de retours. Le même modèle effectue une dernière révision pour chaque combinaison, puis l’étude évalue les résultats sur des tests mis de côté.
Ce protocole permet aux auteurs d’estimer la contribution de chaque ressource à partir d’un état fixe.
Pour les échecs concernant une fonction, les spécifications vérifiées du comportement attendu ont généralement davantage contribué que les retours fondés sur les tests publics. Pour les échecs au niveau d’un dépôt, les fragments de code récupérés ont peu contribué, tandis qu’une spécification élaborée à partir d’un correctif de référence a davantage aidé sur les mêmes états.
Les résultats indiquent que le contenu de l’information compte, mais ils ne valent que pour les échecs figés et le protocole à une seule révision de l’étude.
Ces résultats mesurent l’effet des ressources sur une seule révision à partir d’échecs figés. La spécification du dépôt a été élaborée à partir de correctifs de référence.
L’étude n’établit ni la valeur des retours au fil d’une réparation en plusieurs étapes, ni les informations qu’un agent peut obtenir en pratique.
Ce que montrent les preuves
- Comparer les ressources au même échec
Banzhaf Resource Attribution (BRA) est une méthode qui mesure la contribution du calcul, de l’information et des retours à la réparation d’un état figé où un agent de programmation a échoué. L’article traite d’un problème posé par les réparations habituelles : l’état de l’agent, les ressources reçues et la révision suivante changent ensemble.
Un résultat obtenu sur toute la séquence ne permet donc pas d’isoler la contribution de chaque ressource.
- Garder le même état de réparation
BRA teste toutes les combinaisons de calcul, d’information et de retours sur des copies du même état d’échec. Le même modèle de réparation effectue une dernière révision dans chaque configuration, puis un évaluateur isolé note le résultat sur des tests mis de côté.
Les chercheurs peuvent ainsi estimer la contribution moyenne ajoutée par chaque ressource selon les combinaisons des deux autres, plutôt que de la juger à partir d’un seul ensemble de ressources.
- Les spécifications arrivent en tête pour les tâches sur fonction
Sur 194 échecs concernant une fonction, tirés de MBPP+ et HumanEval+, les spécifications vérifiées du comportement attendu ont eu la contribution moyenne la plus élevée pour cinq modèles de réparation sur six. Le résultat mesuré était la proportion de tests étendus mis de côté qui ont été réussis.
Les spécifications ont ajouté de 0,064 à 0,136 point sur cette échelle de 0 à 1, contre de 0,007 à 0,033 point pour les retours fondés sur les tests publics. Ces moyennes décrivent les échecs évalués, et non toutes les réparations possibles.
- Les contributions varient et se recouvrent
La comparaison au niveau d’une fonction montre aussi que la contribution du calcul diminue avec la capacité des modèles, tandis que celle de l’information persiste. La série de tailles de Qwen3 va dans le même sens jusqu’à 32B, même si les comparaisons entre familles de modèles varient aussi selon le fournisseur.
La plupart des estimations par paire sont négatives : ajouter une deuxième ressource apporte souvent moins que si elle était utilisée seule. La substitution observée est plus marquée loin du plafond du score d’utilité.
- Au niveau du dépôt, le contenu compte
Les résultats au niveau d’un dépôt montrent que la ressource information et le contenu qu’elle apporte sont deux choses distinctes. Cinq fragments de code récupérés n’ont pas de contribution moyenne significative sur 126 correctifs non résolus, alors qu’une spécification vérifiée du correctif a davantage contribué sur ces mêmes échecs.
Dans une expérience distincte sur le choix des ressources, trois modèles qui demandaient généralement des retours ont obtenu de moins bons résultats qu’un choix aléatoire pour les échecs concernant une fonction, où les spécifications avaient tendance à aider le plus.
Détails
- Auteurs de l’article original
- Saiyue Lyu, Jerrold Huang, Yunbei Zhang, Janet Wang, Zhenting Wang
- Soumis à arXiv
- Licence
- CC BY 4.0