ES
El reenmascarado aleatorio permite a los modelos de difusión revisar y mejorar secuencias
En palabras sencillas
Los modelos de difusión enmascarada forman una secuencia revelando varios tokens a la vez. En la decodificación estándar, un token revelado queda fijo, aunque el contexto que aparece después sugiera que era incorrecto.
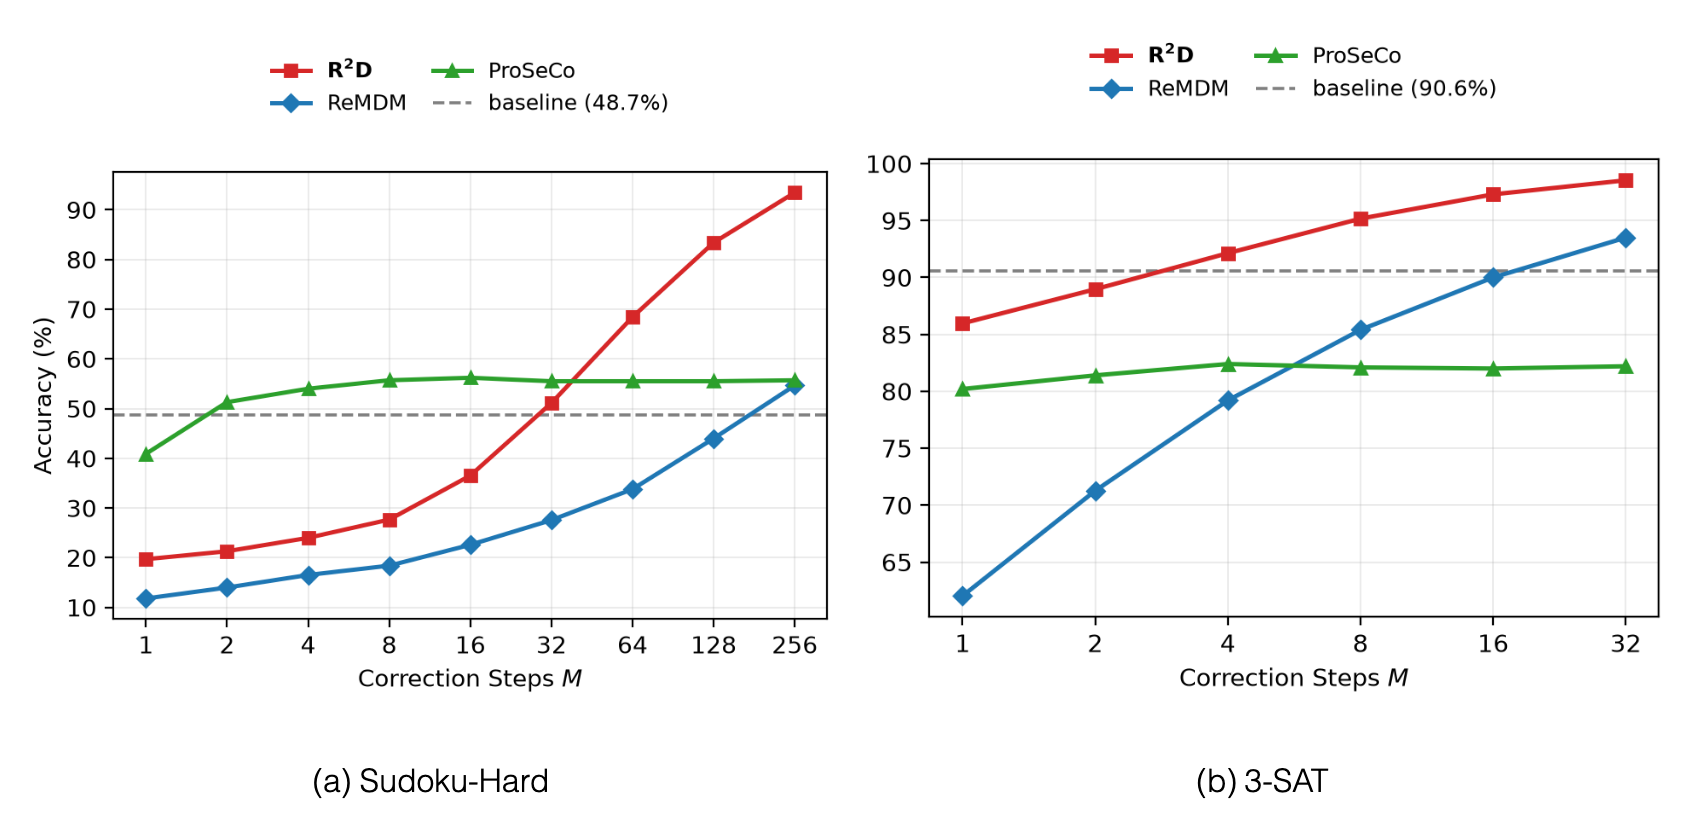
El artículo presenta un método que vuelve a enmascarar y completar la secuencia repetidamente, dando otra oportunidad de corregir las predicciones. En la prueba Sudoku-Hard, su precisión subió del 19,7 % al 93,5 % cuando las rondas de repetición en cada nivel de ruido aumentaron de 1 a 256. Ese resultado corresponde a la tarea y la configuración del modelo reportadas.
La investigación
¿Puede un modelo de difusión enmascarada recuperarse de un token incorrecto que ya reveló, y puede la teoría describir su generación real cuando su modelo de predicción es imperfecto? La decodificación estándar deja fijos los tokens revelados, mientras que los análisis anteriores que comenta el artículo estudian modelos de predicción ideales.
Por eso, no está claro qué efecto tiene la corrección repetida con los modelos aprendidos que se usan en la práctica.
Los autores representan la inferencia como un proceso de reenmascarado y predicción repetidos, derivan una cota para modelos de predicción imperfectos y la usan para diseñar R²D adaptativo.
Con modelos entrenados de forma estándar, más rondas de corrección elevaron la precisión de R²D del 19,7 % al 93,5 % en Sudoku-Hard y del 86,0 % al 98,5 % en 3-SAT; ReMDM también mejoró, pero quedó por debajo con los presupuestos reportados.
Con el mismo modelo entrenado con TCT y los presupuestos de cada tarea, R²D obtuvo un 97,5 % frente al 92,3 % en Sudoku-Hard y un 99,3 % frente al 96,5 % en 3-SAT. La comparación con condiciones igualadas respalda que el procedimiento de inferencia de R²D aporta una ventaja en estas configuraciones.
La regla de detención del método comprueba si la secuencia que predice permanece igual tras varios pasos; no mide directamente la distancia respecto de la distribución de los datos.
Los resultados reportados abarcan dos tareas lógicas y una prueba de programación, con modelos y configuraciones de entrenamiento distintos, por lo que no establecen el rendimiento en todos los modelos de difusión enmascarada ni en todas las familias de tareas.
Qué muestran las pruebas
- El problema de las predicciones fijas
El artículo presenta un marco teórico para la inferencia con difusión enmascarada y el método Random Remask-Denoise (R²D). En la decodificación estándar de difusión enmascarada, los tokens se revelan en paralelo y luego quedan fijos, por lo que un error temprano no se puede revisar.
Los análisis anteriores que comenta el artículo se centran en modelos de predicción ideales, no en la trayectoria real de generación de un modelo aprendido e imperfecto. Los autores preguntan cómo describir y mejorar esa trayectoria.
- Modelar la corrección repetida
El marco representa la inferencia como una cadena de Markov sobre secuencias completas sin enmascarar. En cada paso se vuelve a enmascarar la secuencia y se pide al modelo que la reconstruya.
Una cota para un paso separa la posible reducción de la discrepancia respecto de la distribución de los datos, debida al reenmascarado, del error esperado del modelo de predicción. La cota motiva R²D: repetir el reenmascarado y la predicción en un nivel de ruido y luego pasar a uno menor cuando las predicciones se estabilizan.
- Cómo funciona R²D
R²D comienza con una secuencia completamente enmascarada y vuelve a enmascarar posiciones al azar de manera uniforme entre pasos de predicción. Su versión estándar conserva los tokens revelados, mientras que la versión de corrección permite revisarlos.
Como no se puede calcular de forma práctica la divergencia KL teórica, el método usa una señal aproximada: avanza cuando la secuencia completa predicha permanece igual durante varios pasos. Esa señal de detención es heurística; no mide directamente la convergencia.
- Entrenamiento y evidencia en tareas lógicas
Trajectory Correction Training (TCT) entrena el modelo de predicción con secuencias parcialmente generadas a lo largo de su propia trayectoria. Compara cada token predicho con el objetivo completo, incluidas las posiciones ya reveladas, de modo que los errores anteriores contribuyen a la pérdida.
En Sudoku-Hard y 3-SAT, la precisión de R²D aumentó con el presupuesto de corrección al usar modelos entrenados de forma estándar. Con el mismo modelo entrenado con TCT y los presupuestos de cada tarea, también obtuvo mejores resultados que ReMDM en ambas pruebas.
- Prueba con código generado
Los autores también evalúan R²D en HumanEval+, una prueba para determinar si los programas generados resuelven problemas de programación. Usaron LLaDA2.1-mini tal como estaba disponible, sin TCT ni entrenamiento adicional, y EvalPlus puntuó las respuestas generadas.
R²D alcanzó un 85,4 % de precisión en los 164 problemas, por encima del resultado publicado del modelo en modo Q, de 82,9 %. Los resultados en tareas lógicas y de programación proceden de configuraciones distintas de modelo y entrenamiento.
Detalles
- Autores del paper original
- Zhaoyi Zhou, Frank Wu, Andrea Zanette
- Enviado a arXiv
- Licencia
- CC BY 4.0