FR
Des ancres communes pour transférer les sondes entre modèles de langage
Relative Representations Enable Portable White-Box Monitoring Across Language Models · arXiv:2610.28366
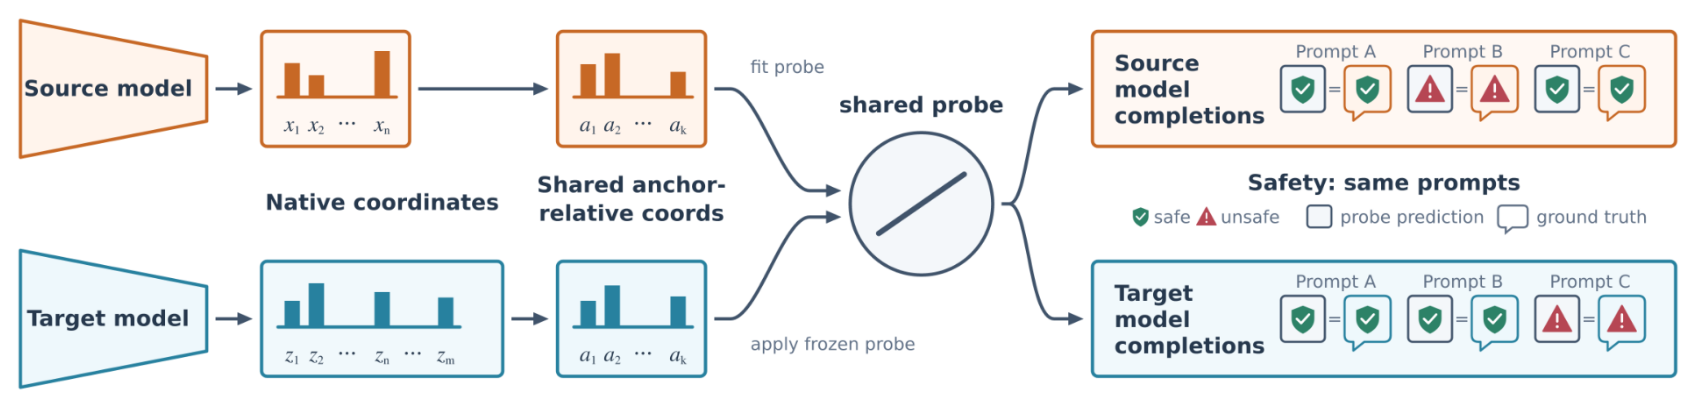
En termes simples
Une sonde est un outil qui lit les signaux internes d’un modèle de langage pour prédire quelque chose sur son comportement. Cet article présente les sondes à ancres globales : elles décrivent chaque exemple par sa distance par rapport aux mêmes exemples de référence dans différents modèles.
Les sondes utilisent ainsi des coordonnées qui ont le même sens, même si les modèles n’ont pas la même taille. Les auteurs constatent qu’une sonde figée reste souvent prédictive d’un modèle à l’autre pour des tâches de culture générale, de sécurité et de mathématiques.
Les résultats varient selon la tâche et le modèle cible, avec notamment un échec du transfert mathématique sur un modèle externe.
La recherche
Un outil de surveillance du comportement entraîné sur un modèle de langage peut-il encore fonctionner après le passage à un autre modèle, alors que leurs coordonnées internes peuvent différer, même à largeur égale ?
Les auteurs examinent si une représentation commune des exemples peut préserver le signal nécessaire pour prédire le comportement du modèle, sans exemples étiquetés provenant de la cible.
Les auteurs représentent les signaux internes des modèles par leur distance à des exemples communs, puis réutilisent une sonde figée pour vérifier si le comportement reste prédictible d’un modèle à l’autre.
Les auteurs représentent chaque exemple par ses distances angulaires aux mêmes exemples de référence indexés dans les deux modèles. Ils entraînent une sonde sur un modèle, la figent, puis l’évaluent sur un autre.
Pour les tâches de culture générale, de sécurité et de mathématiques, le transfert calibré reste prédictif en moyenne.
L’AUROC mesure dans quelle mesure une sonde classe les cas positifs avant les cas négatifs, quels que soient les seuils de décision. Calculé séparément pour chaque type de tâche, le transfert conserve au moins 85 % de l’AUROC obtenue sur le même modèle au-dessus du niveau du hasard.
Comme la règle de décision de la sonde source reste prédictive sur un autre modèle, le résultat étaye l’existence d’une compatibilité fonctionnelle pour les tâches testées.
Le transfert varie selon la tâche et le modèle cible. Sur le modèle externe GPT-OSS-20B, une sonde mathématique transférée donne un résultat proche du hasard, alors qu’une sonde entraînée ensuite sur ce modèle cible peut prédire l’exactitude. L’étude n’établit pas pourquoi le transfert a échoué.
Ce que montrent les preuves
- Pourquoi le transfert est difficile
Une sonde lit les signaux internes d’un modèle de langage pour prédire un comportement, par exemple la réponse qu’il choisira ou l’exactitude d’une solution. Mais une sonde entraînée sur les signaux natifs d’un modèle ne peut généralement pas être appliquée directement à un autre : leurs coordonnées internes peuvent différer, même lorsque leur largeur est identique.
L’article examine si une représentation commune peut permettre au même outil de surveillance du comportement de fonctionner entre des modèles entraînés séparément, sans utiliser les étiquettes du modèle cible.
- Comment les ancres alignent les signaux
L’article présente les sondes à ancres globales, une méthode qui représente chaque exemple par ses distances angulaires à des exemples de référence partagés, appelés ancres. Les auteurs combinent les signaux internes de toutes les couches du Transformer avant de calculer ces distances.
Chaque coordonnée obtenue renvoie ainsi à la même ancre dans chaque modèle. Une sonde entraînée sur la représentation d’un modèle peut alors être figée et appliquée à un autre, sans devoir faire correspondre les couches ni apprendre un adaptateur propre au modèle cible.
- Vérifier le signal avant réutilisation
Avant d’évaluer le transfert, les auteurs vérifient que les ancres préservent un signal prédictif au sein d’un même modèle. Ils comparent les sondes classiques appliquées aux signaux natifs aux sondes à ancres, pour les mêmes tâches et les mêmes étiquettes.
Sur MATH-500, avec le préfixe de solution de 128 jetons défini à l’avance et 2 000 exemples d’entraînement, la sonde à ancres atteint une AUROC de 81,8, contre 77,9 pour la sonde classique. Les comparaisons sur les tâches testées de culture générale et de sécurité montrent également de faibles écarts.
- Ce qui se transfère entre modèles
Les auteurs figent ensuite les sondes entraînées sur des modèles sources et les appliquent aux modèles cibles. Ils choisissent le modèle source selon les résultats de validation obtenus sur d’autres modèles du groupe source, plutôt qu’à partir des étiquettes de la cible.
Calculé séparément pour chaque type de tâche, le transfert calibré conserve au moins 85 % de l’AUROC obtenue sur le même modèle au-dessus du niveau du hasard, pour le choix d’une réponse de culture générale, l’exactitude de cette réponse, la surveillance de sécurité et l’exactitude en mathématiques en ligne.
Ces moyennes indiquent que les sondes restent prédictives dans les conditions testées, mais ne décrivent pas les résultats de chaque modèle cible.
- Les exceptions délimitent le résultat
Le transfert présente des exceptions notables. Pour l’évaluation binaire de l’exactitude des réponses sur TruthfulQA, le transfert calibré atteint en moyenne une AUROC de 73,1, contre 89,1 pour les sondes évaluées sur le même modèle ; sur l’un des modèles cibles, les sondes transférées sont proches du hasard.
Sur la tâche mathématique avec GPT-OSS-20B externe, le transfert est proche du hasard, tandis qu’une sonde entraînée ensuite sur ce modèle peut prédire l’exactitude. Les auteurs interprètent les transferts réussis comme des indices d’une organisation commune pertinente pour la tâche. Les échecs montrent toutefois que la portabilité dépend de la tâche et du modèle cible.
Détails
- Auteurs de l’article original
- Tim Bakker, Christos Louizos
- Soumis à arXiv
- Licence
- CC BY 4.0