FR
Les modèles étudiants de même taille peinent à égaler les modèles accompagnés d’un dispositif
Understanding the Benefits of Scaffolds through Computational Separations · arXiv:2610.27157
En termes simples
Certains modèles sont aidés par une procédure externe qui les appelle plusieurs fois, garde en mémoire les réponses précédentes et choisit quoi essayer ensuite. L’article demande si entraîner un modèle sur des exemples de cette procédure lui permettrait d’obtenir les mêmes résultats seul.
Sur deux puzzles, les modèles étudiants d’une taille proche de celle du modèle utilisé par la procédure restent moins précis lorsqu’ils sont évalués sans elle. Dans certaines configurations, un étudiant plus grand, une procédure plus simple ou un raisonnement entraîné sur des chaînes plus longues réduisent ou comblent l’écart.
La recherche
Un modèle peut gagner en précision grâce à une procédure externe qui effectue des recherches, revient en arrière ou coordonne des appels répétés. Quand l’entraînement peut-il transférer ce gain au modèle pour qu’il fonctionne sans cette procédure, et quand la procédure effectue-t-elle un calcul qu’un modèle de même capacité ne peut pas reproduire ?
Les auteurs entraînent des étudiants sur les traces d’un dispositif et constatent qu’égaler ses gains peut exiger davantage de capacité ou une tâche plus simple.
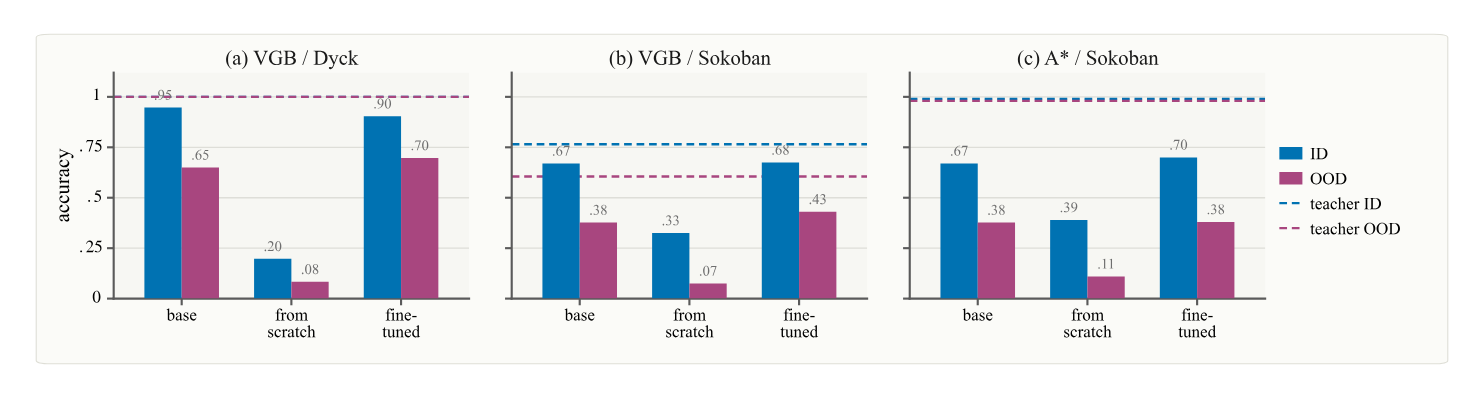
Pour déterminer si les gains d’un dispositif peuvent s’apprendre, les auteurs comparent chaque modèle accompagné de ce dispositif à un étudiant entraîné sur ses traces d’appels et de réponses. Sur Dyck et Sokoban, les étudiants de même taille, évalués sans dispositif, restent moins précis, surtout sur des exemples hors distribution. Les changements d’entraînement testés ne suppriment pas cet écart.
L’écart diminue lorsque l’étudiant grandit, que le dispositif se simplifie ou que l’étudiant apprend une chaîne de solution plus longue. Un théorème conditionnel sur l’accessibilité dans les graphes présente un cas formel où la recherche combinée du dispositif dépasse les capacités de la classe d’étudiants définie.
Ensemble, ces résultats étayent une réponse limitée : l’entraînement sur des traces ne suffit pas nécessairement à transférer le calcul d’un dispositif vers un étudiant de même taille.
Ces résultats portent sur des tâches, des modèles, des procédures d’entraînement et des jeux de test précis.
La séparation théorique dépend aussi d’une hypothèse de complexité explicitée dans l’article ; les expériences ne montrent pas que tous les modèles étudiants soient moins performants que les modèles accompagnés d’un dispositif sur toutes les tâches assistées par un dispositif.
Ce que montrent les preuves
- L’entraînement peut-il intégrer le dispositif ?
L’article demande si un modèle peut intégrer le bénéfice d’une procédure externe qui effectue des appels répétés et s’appuie sur les réponses précédentes pour guider les suivantes.
Les auteurs considèrent la procédure et son modèle comme un enseignant, entraînent un étudiant sur ses traces d’appels et de réponses, puis vérifient si cet étudiant peut atteindre le même niveau sans la procédure.
- Sur les puzzles, les étudiants de même taille sont en retrait
Les auteurs testent la génération de parenthèses imbriquées et les puzzles Sokoban. Ils comparent des modèles accompagnés d’un dispositif à des étudiants d’une taille proche de celle du modèle intégré au dispositif.
L’étudiant apprend à partir des traces de l’enseignant et est évalué seul sur des exemples mis de côté. Les étudiants de même taille restent en retrait, surtout sur des exemples hors distribution, où la fréquence des types de parenthèses ou la longueur des solutions diffère de l’entraînement.
- Les changements d’entraînement ne comblent pas l’écart
Des séries d’entraînements distinctes font varier la part de données correctes, le nombre d’itérations, le nombre de traces et la distribution dont proviennent ces traces. Dans les configurations présentées, les étudiants ne comblent toujours pas l’écart avec l’enseignant.
Davantage de données correctes peut ramener les performances vers le niveau du modèle de base, mais les hausses testées du temps d’entraînement et du nombre de traces, ainsi que l’ajout de traces hors distribution, ne portent pas les étudiants au niveau de l’enseignant accompagné du dispositif.
- Une plus grande capacité peut réduire l’écart
Les résultats changent lorsque la capacité de l’étudiant ou la tâche évolue. Des étudiants plus grands réduisent l’écart, mais l’issue dépend du dispositif.
Un étudiant de même taille égale l’enseignant utilisant un retour en arrière plus simple sur des séquences de parenthèses dans la distribution d’entraînement, mais reste en retrait hors distribution. Dans une tâche d’arithmétique distincte, des chaînes de solution plus longues à apprendre permettent à un modèle d’égaler sa version aidée par la recherche aux longueurs maximales testées.
- La théorie et le transfert nuancent les résultats
Un exemple théorique sur l’accessibilité dans les graphes illustre une limite possible : sous une hypothèse de complexité énoncée, un dispositif peut combiner de simples vérifications d’arêtes en une recherche que la classe d’étudiants de profondeur fixe définie dans l’article ne peut pas effectuer sur toutes les entrées.
Un test de mathématiques de concours relève aussi un écart à mesure que l’arbre d’appels au modèle grandit ; dans cette configuration, un modèle de base plus grand le comble. Une vérification distincte sur des problèmes de preuve apporte peu d’indices d’un gain pour les petits arbres, et aucun étudiant n’a été entraîné sur le plus grand.
Détails
- Auteurs de l’article original
- Jingchu Gai, Adam Block, Andrej Risteski
- Soumis à arXiv
- Licence
- CC BY 4.0