ES
A los estudiantes del mismo tamaño les cuesta igualar a los modelos con harness
Understanding the Benefits of Scaffolds through Computational Separations · arXiv:2610.27157
En palabras sencillas
Algunos modelos reciben ayuda de un procedimiento externo que realiza llamadas repetidas, conserva las respuestas anteriores y decide qué probar después. Este artículo pregunta si entrenar un modelo con ejemplos de ese procedimiento le permite rendir igual de bien por sí solo.
En dos tareas de rompecabezas, los estudiantes de tamaño similar al modelo usado por el procedimiento fueron menos precisos cuando se evaluaron sin él. En algunas configuraciones concretas, estudiantes más grandes, un procedimiento más sencillo o un razonamiento entrenado más largo redujeron o cerraron la brecha.
La investigación
Un modelo puede ganar precisión gracias a un procedimiento externo que busca, retrocede o coordina llamadas repetidas.
¿Cuándo puede el entrenamiento transferir esa mejora al modelo para que funcione sin el procedimiento, y cuándo calcula el procedimiento algo que el modelo no puede reproducir con la misma capacidad?
Los autores entrenan estudiantes con los rastros de un harness y encuentran que igualar sus mejoras puede requerir más capacidad o una tarea más sencilla.
Para comprobar si las mejoras del harness se pueden aprender, los autores comparan cada modelo con harness con un estudiante entrenado con sus rastros de llamadas y respuestas.
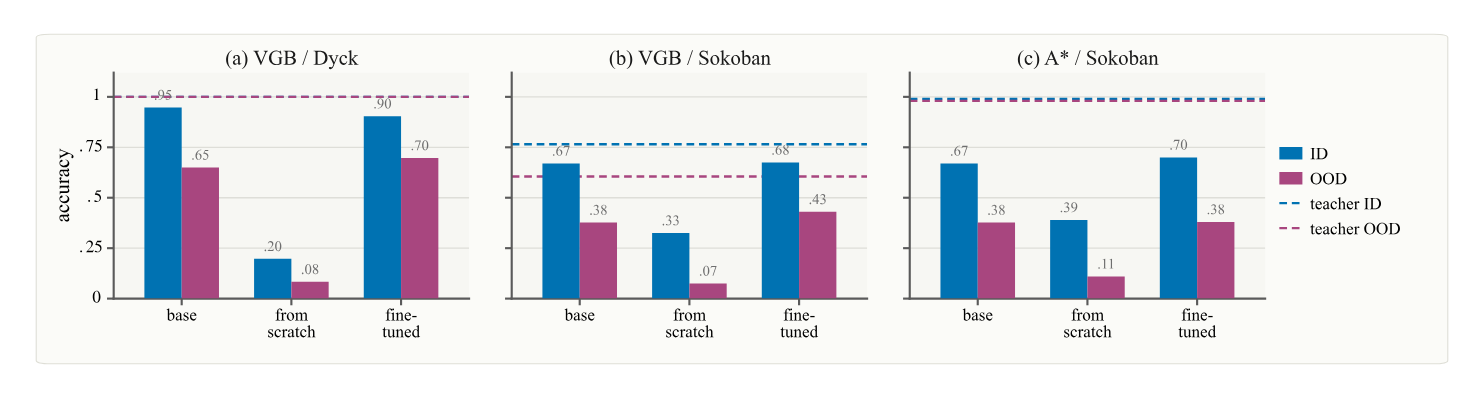
En Dyck y Sokoban, los estudiantes del mismo tamaño, evaluados sin harness, siguen siendo menos precisos, sobre todo en casos fuera de distribución. Los cambios de entrenamiento probados por separado no eliminan esa brecha.
La brecha se reduce cuando el estudiante crece, el harness se simplifica o el estudiante aprende una cadena de solución más larga.
Un teorema condicionado sobre alcanzabilidad presenta un caso formal en que la búsqueda combinada del harness supera la clase de estudiantes definida. En conjunto, los resultados respaldan una respuesta acotada: entrenar solo con rastros no necesariamente transfiere el cálculo del harness a un estudiante del mismo tamaño.
Estos resultados corresponden a tareas, modelos, procedimientos de entrenamiento y particiones de prueba concretos.
La separación teórica también depende de una hipótesis explícita sobre complejidad; los experimentos no muestran que todos los estudiantes rindan peor en todas las tareas asistidas por un harness.
Qué muestran las pruebas
- ¿Puede el entrenamiento incorporar el harness?
El artículo pregunta si un modelo puede incorporar el beneficio de un procedimiento externo que hace llamadas repetidas y usa respuestas anteriores para orientar las siguientes.
Considera que el procedimiento y el modelo juntos forman un profesor, entrena a un estudiante con sus rastros de llamadas y respuestas, y evalúa si ese estudiante puede igualar al profesor sin el procedimiento.
- Los estudiantes del mismo tamaño quedan atrás en los rompecabezas
Los autores prueban la generación de secuencias de corchetes anidados y los rompecabezas Sokoban. Comparan modelos con harness con estudiantes de tamaño similar al modelo dentro del harness.
El estudiante aprende de los rastros del profesor y se evalúa por sí solo en casos reservados. Los estudiantes del mismo tamaño siguen por debajo de sus profesores, en particular en casos fuera de distribución, donde las frecuencias de los corchetes o la longitud de las soluciones difieren de las del entrenamiento.
- Los cambios de entrenamiento no cierran la brecha
En barridos de entrenamiento separados se varían la proporción de datos limpios, las iteraciones de entrenamiento, la cantidad de rastros y la distribución de origen de estos. En las configuraciones reportadas, los estudiantes siguen sin cerrar la brecha respecto del profesor.
Más datos limpios pueden devolver el rendimiento hacia el nivel del modelo base, pero los aumentos probados en tiempo de entrenamiento, cantidad de rastros o rastros fuera de distribución no llevan a los estudiantes al nivel del profesor con harness.
- Más capacidad puede reducir la brecha
Los resultados cambian cuando varía la capacidad del estudiante o la tarea. Los estudiantes más grandes reducen la brecha, aunque el resultado depende del harness.
Un estudiante del mismo tamaño iguala a un profesor más sencillo con retroceso en secuencias de corchetes dentro de la distribución, pero queda por debajo fuera de ella. En otra tarea de aritmética, entrenar cadenas de solución más largas permite que un modelo iguale a la versión asistida por búsqueda en las longitudes máximas probadas.
- La teoría y la transferencia acotan el resultado
Un ejemplo formal de alcanzabilidad explica un posible límite: bajo una hipótesis de complejidad explícita, un harness puede combinar comprobaciones sencillas de aristas en un cálculo de búsqueda que la clase de estudiantes de profundidad fija definida en el artículo no puede realizar para todas las entradas.
Una prueba de matemáticas de competición también detecta una brecha a medida que crece el árbol de llamadas al modelo; un modelo base más grande la cierra en esa configuración. Una comprobación aparte en tareas de demostración aporta evidencia limitada de mejora para árboles pequeños y no incluye un estudiante entrenado con el árbol más grande.
Detalles
- Autores del paper original
- Jingchu Gai, Adam Block, Andrej Risteski
- Enviado a arXiv
- Licencia
- CC BY 4.0