ES
KVStream aprovecha almacenamiento inactivo para servir contextos largos
KVStream: Adaptive Parallel Storage Management for KV Caching in Large-Scale LLM Serving · arXiv:2610.31827
En palabras sencillas
Las indicaciones largas pueden reutilizar partes de texto anteriores que se guardaron, pero quizá no quepan en la memoria más rápida del ordenador. Leerlas del almacenamiento puede ralentizar el modelo, aunque haya otro sistema de almacenamiento casi sin uso.
KVStream es un motor de almacenamiento que lee partes de varios niveles a la vez. En una prueba offline en un único nodo del banco de pruebas, procesó el conjunto de preguntas y respuestas sobre documentos largos 1,49 veces más rápido que LMCache con un modelo de 110.000 millones de parámetros. Los resultados dependen de la carga de trabajo y de la configuración.
La investigación
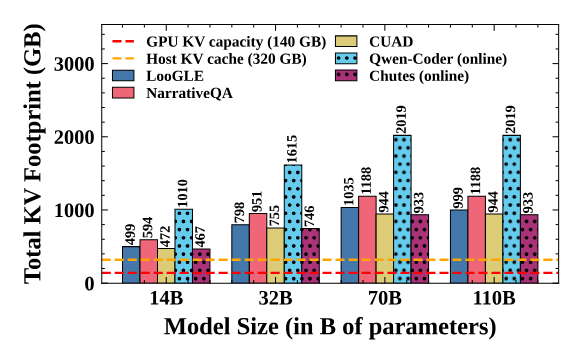
Cuando los prefijos reutilizados ya no caben en la memoria de la GPU y del host, las lecturas de almacenamiento pueden retrasar la inferencia mientras un sistema de archivos paralelo montado transporta poco tráfico de recuperación. ¿Puede un sistema de servicio usar esa capacidad adicional cuando la velocidad de lectura varía de un paso a otro?
KVStream agrupa las lecturas de prefijos en caché entre varios niveles de almacenamiento y permite que cada nivel tome más trabajo al terminar, aprovechando su capacidad de lectura combinada durante la inferencia.
Al servir modelos con contextos largos, los prefijos guardados pueden desbordar la memoria de la GPU y del host, dejando las lecturas de almacenamiento en la ruta de inferencia.
No está claro si un sistema de archivos paralelo ya montado puede ayudar junto con el almacenamiento local cuando el sistema existente lee las solicitudes de forma secuencial.
KVStream agrupa las lecturas de cada paso y permite que cada nivel de almacenamiento tome más bloques al terminar.
En pruebas separadas, los investigadores observaron un mayor rendimiento offline en una carga de trabajo con documentos largos y un menor tiempo online hasta el primer token cuando las llegadas eran irregulares; estos resultados concuerdan con que una recuperación más rápida puede ayudar al servicio en esas configuraciones.
Las mejoras dependen de que las lecturas de almacenamiento sigan siendo importantes y de que se reutilicen muchos prefijos.
Cuando la reutilización se redujo artificialmente al 4% en la traza del agente de programación, el tiempo promedio hasta el primer token de KVStream fue mayor que el de LMCache; además, las escrituras replicadas consumen ancho de banda.
Qué muestran las pruebas
- Un cuello de botella en el almacenamiento
KVStream es un motor de almacenamiento que recupera prefijos guardados de la caché de pares clave-valor desde varios niveles de almacenamiento durante la inferencia de modelos de lenguaje grandes. Está pensado para servir contextos largos cuyos prefijos reutilizados desbordan la memoria de la GPU y del host.
La pregunta que motiva el trabajo es si el sistema de archivos paralelo ya montado en un servidor puede ayudar a recuperar esos prefijos, en vez de dejar casi sin usar su ancho de banda.
- Por qué importa la recuperación
Los investigadores midieron LMCache al procesar LooGLE, un conjunto de datos de preguntas y respuestas sobre documentos largos, en Testbed-1. Con cuatro tamaños de modelo, recuperar prefijos ocupó entre el 80 y el 88% del tiempo de procesamiento, y las lecturas se hacían solicitud por solicitud.
Este diagnóstico explica por qué acelerar la recuperación puede ser relevante para el rendimiento de la inferencia en esa configuración; esa proporción corresponde a esa carga de trabajo y ese banco de pruebas.
- Reparto de lecturas al terminar cada nivel
KVStream agrupa las lecturas de almacenamiento de todo un paso de inferencia, retrasa las escrituras hasta el paso hacia delante y copia cada bloque nuevo de caché en todos los niveles. Cuando un nivel termina un lote, toma más bloques pendientes.
Así, los niveles comparten el trabajo según cuándo terminan, en lugar de seguir una división fija elegida de antemano.
- Dos resultados de servicio
Al servir LooGLE offline en un solo nodo de Testbed-1, el modelo 110B procesó tokens 1,49 veces más rápido con KVStream que con LMCache. En una evaluación online independiente, el tiempo promedio hasta el primer token para 4.000 solicitudes de agentes de programación fue 6,07 veces más rápido con un coeficiente de variación de llegadas de 4. Son medidas distintas en configuraciones diferentes, no una cifra general de rendimiento.
- Cuándo se reduce la mejora
Una ablación offline gradual mostró pocos cambios en el rendimiento por agrupar las lecturas o retrasar las escrituras por separado; añadir un segundo nivel y luego el reparto según la finalización elevó el rendimiento en esa configuración. Sin embargo, cuando la reutilización de prefijos se redujo artificialmente al 4% en la traza online, KVStream tardó más que LMCache en generar el primer token, en promedio.
Las escrituras replicadas consumen ancho de banda, así que la mejora depende de que la demanda de lecturas de almacenamiento sea suficiente para compensar ese coste.
Detalles
- Autores del paper original
- Avinash Maurya, Jaiaid Mobin, Jie Ye, M. Mustafa Rafique, Franck Cappello
- Enviado a arXiv
- Licencia
- CC BY 4.0