IT
KVStream sfrutta lo storage inattivo per accelerare il serving dei modelli con contesti lunghi
KVStream: Adaptive Parallel Storage Management for KV Caching in Large-Scale LLM Serving · arXiv:2610.31827
In parole semplici
I prompt lunghi possono riutilizzare parti di testo già elaborate, ma queste parti salvate potrebbero non entrare nella memoria più veloce del computer. Leggerle dallo storage può rallentare il modello, anche quando un altro sistema di storage resta quasi inutilizzato.
KVStream è un motore di storage che legge parti di dati da più livelli contemporaneamente. In un test offline su un singolo nodo del testbed, con un modello da 110 miliardi di parametri, ha elaborato il dataset di question answering su documenti lunghi 1,49 volte più velocemente di LMCache. I risultati dipendono dal carico di lavoro e dalla configurazione.
La ricerca
Quando i prefissi riutilizzati non entrano più nella memoria della GPU e dell’host, le letture dallo storage possono ritardare l’inferenza mentre un file system parallelo già collegato riceve poco traffico di retrieval.
Un sistema di serving può sfruttare questa capacità di storage aggiuntiva quando la velocità di lettura varia da un passo all’altro?
KVStream raccoglie le letture dei prefissi memorizzati nella cache tra più livelli di storage e permette a ciascun livello di prendere altro lavoro quando finisce, sfruttando la loro capacità di lettura combinata durante l’inferenza.
Nel serving di modelli con contesti lunghi, i prefissi salvati possono superare la memoria della GPU e dell’host, lasciando le letture dallo storage nel percorso dell’inferenza.
Non è chiaro se un file system parallelo già collegato possa affiancare lo storage locale quando il sistema esistente legge le richieste in sequenza.
KVStream raccoglie le letture di un passo e permette a ciascun livello di storage di prendere altri blocchi quando finisce il proprio batch.
In test separati, i ricercatori hanno rilevato un throughput offline maggiore su un carico di lavoro con documenti lunghi e un tempo online fino al primo token minore in presenza di arrivi irregolari, risultati coerenti con un contributo del retrieval più rapido al serving in quelle configurazioni.
I vantaggi dipendono dal fatto che le letture dallo storage restino rilevanti e che il riutilizzo dei prefissi sia sostanziale.
Nel trace dell’agente di coding, riducendo sinteticamente il riutilizzo al 4%, il tempo medio di KVStream fino al primo token è stato più lento di quello di LMCache; anche le scritture replicate consumano larghezza di banda.
Cosa mostrano le prove
- Un collo di bottiglia nello storage
KVStream è un motore di storage che recupera prefissi memorizzati nella cache key-value da più livelli di storage durante l’inferenza di modelli linguistici di grandi dimensioni. È pensato per il serving con contesti lunghi, in cui i prefissi riutilizzati non entrano più nella memoria della GPU e dell’host.
La domanda di partenza è se il file system parallelo già collegato a un server possa aiutare a recuperare quei prefissi, invece di lasciare quasi inutilizzata la sua larghezza di banda.
- Perché il retrieval conta
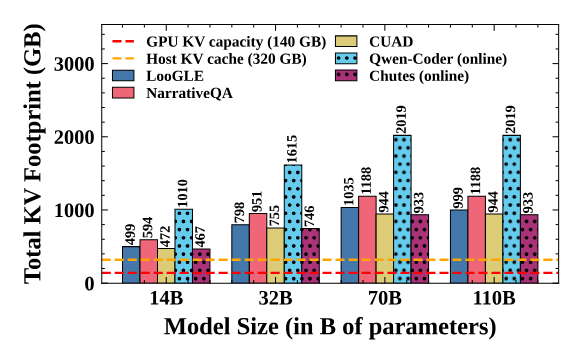
I ricercatori hanno misurato LMCache mentre serviva LooGLE, un dataset di question answering su documenti lunghi, su Testbed-1. Con quattro dimensioni del modello, il retrieval dei prefissi ha richiesto l’80–88% del tempo di elaborazione e le letture procedevano una richiesta alla volta.
In quella configurazione, la diagnosi rende rilevante accelerare il retrieval per migliorare l’inferenza; la quota osservata riguarda però quel carico di lavoro e quel testbed.
- Letture condivise man mano che i livelli finiscono
KVStream raccoglie le letture dallo storage per un intero passo di inferenza, rimanda le scritture fino al forward pass e copia ogni nuovo blocco della cache su tutti i livelli. Quando un livello termina un batch, può prelevare altri blocchi non ancora letti.
In questo modo i livelli condividono il lavoro in base a quando terminano, invece di seguire una divisione fissa stabilita in anticipo.
- Due risultati di serving
Nel serving offline di LooGLE su un nodo Testbed-1, il modello 110B ha elaborato i token 1,49 volte più velocemente con KVStream che con LMCache. In una valutazione online separata, il tempo medio fino al primo token per 4.000 richieste di un agente di coding è stato 6,07 volte più veloce quando il coefficiente di variazione degli arrivi era 4.
Sono misure diverse, ottenute in configurazioni diverse, non un unico dato generale sulle prestazioni.
- Quando il vantaggio si riduce
Un’ablation offline incrementale ha rilevato che raggruppare le letture in batch o rimandare le scritture, da soli, modificavano poco il throughput; aggiungere un secondo livello e poi l’assegnazione guidata dal completamento lo ha aumentato in quella configurazione.
Ma quando, nel trace online, il riutilizzo dei prefissi è stato ridotto sinteticamente al 4%, il tempo medio di KVStream fino al primo token è stato più lento di quello di LMCache. Le scritture replicate consumano larghezza di banda: il risultato dipende quindi dal fatto che la domanda di letture dallo storage sia abbastanza alta da compensarne il costo.
Dettagli
- Autori del paper originale
- Avinash Maurya, Jaiaid Mobin, Jie Ye, M. Mustafa Rafique, Franck Cappello
- Inviato ad arXiv
- Licenza
- CC BY 4.0