FR
KVStream exploite le stockage disponible pour accélérer le service des modèles à long contexte
KVStream: Adaptive Parallel Storage Management for KV Caching in Large-Scale LLM Serving · arXiv:2610.31827
En termes simples
Les longues invites peuvent réutiliser des morceaux de texte déjà traités. Mais ces morceaux peuvent ne pas tenir dans la mémoire la plus rapide de l’ordinateur. Les lire depuis le stockage peut ralentir le modèle, même si un autre système de stockage reste largement inutilisé.
KVStream est un moteur de stockage qui lit des morceaux sur plusieurs niveaux de stockage en même temps. Dans un test hors ligne mené sur un seul nœud du banc d’essai avec un modèle de 110 milliards de paramètres, il a traité le jeu de données de questions-réponses sur de longs documents 1.49 fois plus vite que LMCache. Les résultats dépendent de la charge de travail et de la configuration.
La recherche
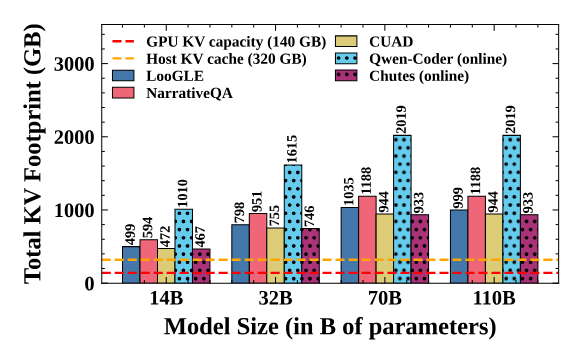
Lorsque les préfixes réutilisés ne tiennent plus dans la mémoire du GPU et de l’hôte, les lectures depuis le stockage peuvent retarder l’inférence, tandis qu’un système de fichiers parallèle monté reçoit peu de trafic de récupération.
Un système de service peut-il exploiter cette capacité de stockage supplémentaire lorsque les vitesses de lecture varient d’une étape à l’autre ?
KVStream regroupe la lecture des préfixes mis en cache sur plusieurs niveaux de stockage et permet à chacun de prendre davantage de travail une fois prêt, afin d’exploiter leur débit de lecture combiné pendant l’inférence.
Lors du service de modèles à long contexte, les préfixes sauvegardés peuvent dépasser la mémoire du GPU et de l’hôte, ce qui place les lectures depuis le stockage sur le parcours d’inférence.
On ne sait pas encore si un système de fichiers parallèle monté peut aider en complément du stockage local, alors que le système existant lit les requêtes de façon séquentielle.
KVStream regroupe les lectures d’une étape et permet à chaque niveau de stockage de prendre davantage de blocs à mesure qu’il termine.
Dans des tests distincts, les chercheurs ont observé un débit hors ligne plus élevé sur une charge de travail de documents longs et un temps en ligne avant le premier jeton plus court lorsque les arrivées étaient irrégulières ; ces résultats concordent avec l’idée qu’une récupération plus rapide peut améliorer le service dans ces configurations.
Les gains dépendent de l’importance des lectures sur le stockage et d’un partage substantiel des préfixes.
Lorsque le partage a été artificiellement ramené à 4 % dans la trace d’un agent de programmation, le temps moyen avant le premier jeton de KVStream était plus long que celui de LMCache ; les écritures répliquées consomment aussi de la bande passante.
Ce que montrent les preuves
- Un goulot d’étranglement côté stockage
KVStream est un moteur de stockage qui récupère des préfixes mis en cache sous forme de paires clé-valeur sur plusieurs niveaux de stockage pendant l’inférence de grands modèles de langage.
Il vise le service de contextes longs, où les préfixes réutilisés débordent de la mémoire du GPU et de l’hôte. La question de départ est de savoir si le système de fichiers parallèle déjà monté sur un serveur peut aider à récupérer ces préfixes au lieu de laisser sa bande passante largement inutilisée.
- Pourquoi la récupération compte
Les chercheurs ont mesuré LMCache servant LooGLE, un jeu de données de questions-réponses sur de longs documents, sur Testbed-1. Pour quatre tailles de modèle, la récupération des préfixes représentait 80–88 % du temps de traitement, et les lectures se faisaient requête après requête.
Ce constat rend la récupération plus rapide pertinente pour les performances d’inférence dans cette configuration ; cette proportion reste propre à cette charge de travail et à ce banc d’essai.
- Répartir les lectures au fil des achèvements
KVStream regroupe les lectures de stockage nécessaires à une étape entière d’inférence, reporte les écritures jusqu’après le passage avant et copie chaque nouveau bloc de cache sur tous les niveaux. Lorsqu’un niveau termine un lot, il réclame d’autres blocs non lus.
Les niveaux se répartissent ainsi le travail selon leur rythme d’achèvement, plutôt que selon une division fixe choisie à l’avance.
- Deux résultats de service
Lors du service hors ligne de LooGLE sur un seul nœud Testbed-1, le modèle 110B a traité les jetons 1.49 fois plus vite avec KVStream qu’avec LMCache. Dans une évaluation en ligne distincte, le temps moyen avant le premier jeton pour 4,000 requêtes d’agents de programmation était 6.07 fois plus rapide lorsque le coefficient de variation des arrivées était de 4.
Ces mesures proviennent de configurations différentes et ne constituent pas un indicateur général unique des performances.
- Quand le gain se réduit
Une ablation hors ligne progressive a révélé que le regroupement des lectures ou le report des écritures, pris isolément, modifiait peu le débit ; l’ajout d’un second niveau, puis du routage selon l’achèvement, a augmenté le débit dans cette configuration.
Mais lorsque le partage des préfixes a été artificiellement ramené à 4 % dans la trace en ligne, KVStream a affiché un temps moyen avant le premier jeton plus long que LMCache. Les écritures répliquées consomment de la bande passante : le résultat dépend donc d’une demande de lecture assez importante pour compenser ce coût.
Détails
- Auteurs de l’article original
- Avinash Maurya, Jaiaid Mobin, Jie Ye, M. Mustafa Rafique, Franck Cappello
- Soumis à arXiv
- Licence
- CC BY 4.0